Kiek RAM reikia, kad DI veiktų vietoje jūsų nešiojamajame?
3,4 GB dydžio failas qwen3.5:4b-q4_K_M (LLM, arba didelis kalbos modelis) jau šį vakarą gali atsakyti į klausimą įprastame nešiojamajame su 16 GB atminties, be jokios debesijos paskyros. Atsisiųskite jį per Ollama, užduokite vieną klausimą su 4K kontekstu, ir jau paleisite tikrą DI modelį vietoje, savo kompiuteryje. Jis apdoroja tekstą ir vaizdus, o čia kalbame apie išvedimą, ne mokymą: niekas modelio nemoko nieko naujo, jis tiesiog atsako.
Neaiškus lipdukas „AI PC“ ant nešiojamojo dėžės nėra specifikacija. Svarbu RAM, GPU prieinama atmintis, saugykla ir realus programinės įrangos palaikymas. 16 GB atminties yra tikras atspirties taškas mažiems DI modeliams, bet tai nėra nei per menka riba, kurią galima iškart atmesti, nei pažadas, kad veiks viskas, kas parašyta specifikacijose. Daugiau atminties reiškia daugiau konteksto ir daugiau erdvės kelioms užduotims. Pradžiai 16 GB pakanka.
Kas iš tikrųjų naudoja jūsų nešiojamojo RAM, kai paleidžiate DI
Modelio atsisiuntimo dydis ir tai, kiek RAM jis naudoja veikdamas, yra du skirtingi skaičiai. Juos supainioti, dažniausia klaida renkantis nešiojamąjį DI užduotims. Tie 3,4 GB, kuriuos atsisiunčiate qwen3.5:4b-q4_K_M modeliui, yra failas diske. Jam įkelti reikia tikros atminties. Jos taip pat reikia konteksto langui, tai yra vykstančiam pokalbiui, kurį modelis išlaiko atsakydamas, vadinamajam KV cache. Atminties reikia ir pačiam varikliui, ir viskam kitam, ką jau naudoja jūsų operacinė sistema bei kitos programos.
Ollama pagal numatytuosius nustatymus įkelia 4 096 žetonų kontekstą, bet jį galima padidinti. Jei vienu metu vykdote kelias užklausas, kontekstui reikalinga atmintis daugėja maždaug pagal lygiagrečių užklausų skaičių. Modelio specifikacijose gali būti nurodytas 128K ar 256K žetonų konteksto langas, tačiau tai vertinkite kaip modelio ribą, o ne pažadą, kad jūsų nešiojamasis su 16 GB galės tuo pat metu patogiai išnaudoti visą šį kiekį.
RAM, VRAM ir bendroji atmintis nėra tas pats
Apple Silicon lustai naudoja bendrąją atmintį: CPU ir GPU naudojasi tuo pačiu 16, 24 arba 32 GB atminties kiekiu, todėl čia nėra atskiros vaizdo atminties, kuri galėtų baigtis. Įprastas Windows ar Linux nešiojamasis su atskira NVIDIA vaizdo plokšte veikia kitaip. Sistemos RAM ir pačios GPU VRAM yra du atskiri telkiniai, todėl 16 GB sistemos RAM ir 8 GB vaizdo plokštė nėra vienas bendras 24 GB kiekis, kuriuo modelis gali laisvai naudotis.
Kai modelis visas netelpa į GPU atmintį, dalis jo vykdoma per CPU. Toks dalinis perkėlimas techniškai leidžia modelį paleisti, bet jis gali veikti pastebimai lėčiau. Paleiskite , ir pamatysite tikslų CPU ir GPU pasiskirstymą to, kas tuo metu įkelta.
Talpa yra tik pusė istorijos. Ne mažiau svarbu ir tai, kaip greitai duomenys juda atmintyje: Apple nurodo 153 GB/s atminties pralaidumą MacBook Air M5 modeliui, ir būtent pralaidumas, o ne vien talpa, yra viena iš priežasčių, kodėl bendroji atmintis atrodo sparti, o ne tik teoriškai pakankama.
Kvantizavimas: kaip 9B DI modelis sumažinamas, kad tilptų į RAM
Kvantizavimas ir lemia tą 3,4 GB atsisiuntimą: kai modelio svoriai saugomi mažesniu skaitiniu tikslumu, failas sumažėja, o pačios Qwen3.5 9B modelio versijos tai aiškiai parodo. Tas pats 9B modelis atsisiunčiamas kaip 6,6 GB Q4_K_M versija, 11 GB Q8_0 versija ir 19 GB pilno BF16 tikslumo versija. Tas pats modelis, tas pats parametrų skaičius, bet trys labai skirtingi atsisiuntimo dydžiai. Ir vėlgi, tai yra atsisiuntimo dydis, o ne RAM kiekis, kurio prireiks veikimo metu.
Mažesnis tikslumas paprastai kainuoja šiek tiek kokybės, tačiau kiek jos prarandama, priklauso nuo užduoties, o ne nuo kokio nors fiksuoto procento. Prieš renkantis Qwen kaip pirmą modelį verta žinoti vieną praktinį niuansą: kai kurie naudotojai pastebi, kad jo „mąstymo“ etapas prieš pateikiant atsakymą sukuria juntamą delsą, palyginti su modeliais, kurie atsako tiesiau. Todėl verta išbandyti abu stilius su savo užduotimis, o ne manyti, kad vienas jų tiesiog geresnis.
Jau turite 16 GB MacBook? Pirmiausia išbandykite štai ką
Jei jau turite 16 GB MacBook, prieš galvodami apie pirkimą pradėkite nuo 2–4B modelio su Q4 tikslumu ir 4K kontekstu. Gali pavykti įkelti ir 9B Q4 modelį arba, pavyzdžiui, Gemma 4 12B QAT. Ar pavyks, priklauso nuo to, kiek kitų programų atidaryta, kiek konteksto naudojate ir kiek tuo metu apkrautas kompiuteris, todėl pabandyti verta, bet tai nėra garantija.
Jei tokį kompiuterį perkate specialiai šiam tikslui, 13 colių MacBook Air su M5 lustu standartiškai turi 16 GB bendrosios atminties, o konfigūracija gali siekti iki 32 GB. O jei didesnis ekranas jau atrodo kaip savaiminis atnaujinimas, 15 colių M5 Air siūlomas su tais pačiais 16, 24 ir 32 GB atminties variantais bei tuo pačiu 153 GB/s pralaidumu kaip ir 13 colių modelis. Ekrano dydį rinkitės dėl patogumo, o ne todėl, kad jis suteiktų daugiau erdvės DI užduotims. Nesuteikia.

Jau turite 16 GB Windows arba Linux nešiojamąjį? Pradėkite čia
16 GB Windows arba Linux nešiojamasis be atskiros vaizdo plokštės vis tiek gali paleisti mažą modelį. Ollama veikia Windows sistemoje natūraliai, tad pirmiausia atsisiųskite 2–4B Q4 modelį ir išbandykite jį per CPU arba integruotą grafiką, prieš leisdami pinigus. Patirtis čia gali skirtis labiau nei naudojant Apple Silicon: vieno fiksuoto žetonų per sekundę skaičiaus, tinkančio visiems kompiuteriams, tiesiog nėra, nes niekas neišmatavo kiekvienos įmanomos konfigūracijos.
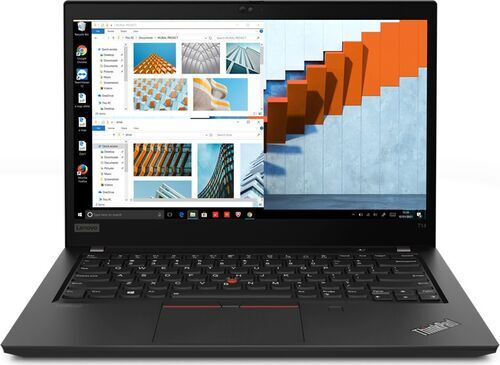
Lenovo ThinkPad T14 G2 ir HP EliteBook x360 1040 G7 abu turi po 16 GB RAM ir integruotą grafiką, tai būtent ši kategorija. Vieną dalyką verta pasitikrinti iš anksto, ypač jei žiūrite senesnį atnaujintą modelį, kaip šiuos du: LM Studio Windows x64 sistemoje reikalauja AVX2 palaikymo, o ne visi senesni procesoriai turi šį instrukcijų rinkinį. Prieš manydami, kad bet kuris tokio lygio nešiojamasis paleis pasirinktą įrankį, įsitikinkite, kad jūsų konkretus procesorius jį palaiko.
Nešiojamųjų GPU pavadinimų spąstai: kodėl „RTX 5070 Ti“ nėra vienas skaičius
NVIDIA nešiojamųjų GPU turi tuos pačius pavadinimus kaip ir stalinėms sistemoms skirti modeliai, bet iš to pavadinimo sužinosite mažiau, nei gali pasirodyti. RTX 5060 Laptop GPU turi 8 GB GDDR7 atminties ir oficialiai nurodomą 45–100 vatų galios diapazoną. RTX 5070 Ti Laptop GPU turi 12 GB GDDR7 ir 60–115 vatų diapazoną. Internete rastas stalinio RTX 5070 Ti rezultatas nėra nešiojamojo RTX 5070 Ti rezultatas, kad ir ką sufleruotų pavadinimas.
Tame pačiame pavadinime slypi ir antri spąstai. Du nešiojamieji gali turėti „RTX 5070 Ti Laptop GPU“ ir vis tiek veikti skirtingai esant ilgalaikei apkrovai: plonas ir lengvas korpusas bei storesnis ir sunkesnis modelis skirtingai tvarkosi su šiluma, todėl tas pats GPU pavadinimas negarantuoja tokio pat realaus greičio, kai ventiliatoriai jau kurį laiką sukasi. Visada tikrinkite tikslų VRAM kiekį ir paties nešiojamojo galios konfigūraciją, o ne vien GPU šeimos pavadinimą.
Perkate Mac vietiniam DI? Patogesnis bendrosios atminties lygis
Jei kompiuterį perkate būtent tam, kad reguliariai paleistumėte DI modelius vietoje, 24–32 GB bendrosios atminties yra patogesnis Apple pasirinkimas: jis suteikia realios erdvės didesniam modeliui, ilgesniam kontekstui arba tiesiog leidžia darbo metu laikyti atidarytas kitas programas. Jei planuojate tai naudoti dažnai ir biudžetas leidžia, rinkitės 32 GB.
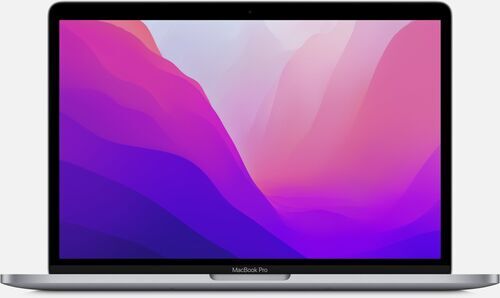
13 colių MacBook Pro su M2 lustu yra geras atnaujintas pavyzdys, jau esantis aukščiau už 16 GB pradinį lygį: jo 8 branduolių CPU ir 10 branduolių GPU gali būti derinami su iki 24 GB bendrosios atminties. Tai senesnės kartos lustas nei M5 Air, todėl čia reikia tikėtis būtent 24 GB ribos, o ne atskirų 24 ir 32 GB variantų, kuriuos siūlo M5 Air.
Perkate Windows arba Linux kompiuterį? Ieškokite atskiros vaizdo plokštės
Jei naują Windows arba Linux kompiuterį renkate vietiniam DI, ieškokite 32 GB sistemos RAM ir atskiros NVIDIA nešiojamųjų GPU vaizdo plokštės su bent 8 GB nuosavos VRAM, o jei priimtinas kiek sunkesnis ar brangesnis kompiuteris, geriau 12 GB. 8 GB yra realus tikslas 4–7B modeliams su Q4 tikslumu ir vidutinio dydžio kontekstu, tačiau nelaikykite to automatine atsarga: net ir 6,6 GB dydžio 9B Q4 modelio atsisiuntimui gali reikėti daugiau nei vien 8 GB, kad veiktų patogiai, o 12 GB tiesiog leidžia lengviau bandyti tokio dydžio modelius.
Dell Precision 7730 yra geras atnaujintas šios idėjos pavyzdys, nors jame ir nėra būtent tų naujų lustų, apie kuriuos kalbėta aukščiau: 32 GB sistemos atminties čia derinama su atskira NVIDIA Quadro P3200, turinčia savo 6 GB VRAM. Tai kita GPU karta ir kita klasė nei dabartiniai NVIDIA RTX 5060 bei 5070 Ti Laptop GPU, bet atskirų atminties telkinių principas tas pats.

Atsakinga alternatyva: AMD nešiojamųjų lustai su daug atminties
AMD Ryzen AI Max+ 395 procesorius palaiko iki 128 GB LPDDR5x sistemos atminties, priklausomai nuo to, kaip sukonfigūruotas konkretus nešiojamasis. Tai kitokia atminties architektūra, apie kurią verta žinoti, tačiau yra vienas svarbus niuansas: Ollama Linux ROCm palaikymo sąraše šis lustas nurodomas, o Windows ROCm sąraše šiuo metu jo nėra.
Tai nereiškia, kad lustą reikia iškart atmesti. Tai reiškia, kad prieš rekomenduojant konkretų nešiojamąjį verta patikrinti tikslų įdiegtos atminties kiekį, operacinę sistemą, GPU posistemę, tvarkykles ir tai, kaip su juo elgiasi Ollama. Nešiojamąjį su daug atminties ir AMD architektūra vertinkite kaip įdomią alternatyvą, kurią reikia atidžiai išnagrinėti, o ne kaip numatytą pirmą pirkinį žmogui, tik pradedančiam paleisti DI vietoje.
Programinė dalis: Ollama ir LM Studio paprastai
Ollama yra paprasčiausias būdas priversti modelį veikti jūsų kompiuteryje: atsisiunčiate modelį, paleidžiate jį, ir turite vietinį serverį, kuris atsako į užklausas, be jokios debesijos paskyros atsisiųstam modeliui. Būtent šis įrankis naudojamas visuose čia pateiktuose pavyzdžiuose.
LM Studio siūlo grafinę alternatyvą su savo modelių naršykle ir pokalbių langu. Jis pats nurodo minimalius reikalavimus: bent 16 GB RAM Mac arba Windows kompiuteriui, AVX2 palaikymas Windows x64 sistemoje ir rekomenduojami 4 GB atskiros VRAM Windows aplinkoje. Tinkamas abiejų įrankių paruošimas yra atskira tema.
Ir vienas perspėjimas prieš pasitikint vienu internete rastu greičio skaičiumi: oficialus llama-bench įrankis atskiria užklausos apdorojimo spartą nuo generavimo spartos ir rodo pakartotinių bandymų skirtumus, o ne vieną vienintelį rezultatą. Forumo įraše pateiktas vienas žetonų per sekundę skaičius retai pasako, kuri iš šių dviejų spartų buvo matuota ir kiek kartų testas kartotas.
Kontrolinis sąrašas perkant ar atnaujinant DI paruoštą nešiojamąjį
Prieš pirkdami ar atnaujindami kompiuterį būtent vietiniam DI, tikrinkite konkrečius dalykus, o ne rinkodarines etiketes.
Tikslus GPU modelis ir VRAM. Ne vien GPU šeimos pavadinimą, o konkretų nešiojamojo variantą ir jo atminties kiekį, nes po tuo pačiu pavadinimu gali slėptis skirtingi VRAM kiekiai.
Lituota ar atnaujinama RAM. Kai kuriuose nešiojamuosiuose atmintį vėliau galima pridėti, daugelyje šiuolaikinių plonų ir lengvų modelių – ne. Žinokite, kurį variantą perkate.
Laisva SSD vieta. Modelių atsisiuntimai svyruoja nuo mažiau nei 1 GB iki gerokai daugiau nei 10 GB, o didėjanti jų kolekcija kartu su kitais jūsų failais vietą užpildo greitai.
Šiluminis elgesys esant ilgalaikei apkrovai. Vienas modelio atsakymas į vieną klausimą ir nešiojamasis, apdorojantis kelias užklausas iš eilės, yra skirtingi testai; ventiliatorių triukšmas ir spartos ribojimas po pakartotinių užklausų pasako daugiau nei vienas trumpas demonstracinis bandymas.
OS ir tvarkyklių palaikymas. Prieš ką nors numanydami, įsitikinkite, kad jūsų tiksli GPU posistemės ir operacinės sistemos kombinacija palaikoma Ollama arba LM Studio.
NPU TOPS skaičius ant dėžės nėra našumo garantija. Tai rinkodarinis skaičius, o ne išbandytas rezultatas iš variklio, kurį iš tikrųjų naudosite. Miglotas „AI PC“ užrašas nepakeičia nė vieno iš šių patikrinimų.
Penki atnaujinti nešiojamieji, kurie jau atitinka šiuos lygius

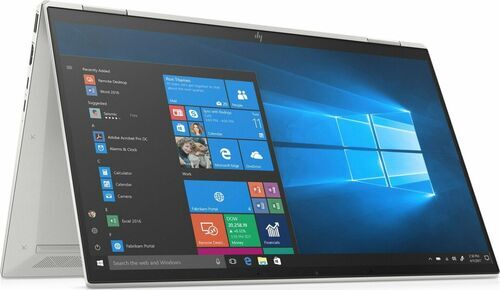
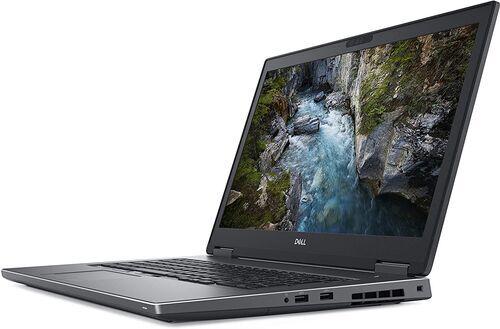
Dažniausiai užduodami klausimai apie DI paleidimą nešiojamajame
Ar reikia atskiros vaizdo plokštės, kad DI veiktų vietoje?
Ne. Mažas modelis daugelyje 16 GB nešiojamųjų veikia per CPU arba integruotą grafiką, tik spartos pojūtis čia labiau skiriasi nei kompiuteryje su atskira vaizdo plokšte. Pradėkite nuo 2–4B modelio, prieš nuspręsdami, kad atskiros grafikos jums apskritai reikia.
Ar pakaks 8 GB RAM?
Ne, bent jau ne patogiai tiems modeliams, apie kuriuos kalbama čia. 16 GB yra realistiška pradžia, kai įvertinate, kad tą pačią atmintį dalijasi modelis, jo konteksto langas, variklis ir operacinė sistema.
Ar modelio paleidimas vietoje yra tas pats, kas jo mokymas?
Ne. Visa tai, apie ką kalbėjome aukščiau, yra išvedimas: klausimų uždavimas jau išmokytam modeliui. Mokymas reiškia kurti modelį nuo nulio, o tam reikia gerokai daugiau techninės įrangos nei turi kuris nors čia minimas nešiojamasis.
Ar daugiau RAM garantuoja greitesnius atsakymus?
Ne. Didesnė atmintis suteikia daugiau erdvės didesniems modeliams, ilgesniam kontekstui ir daugiau atidarytų programų, bet tikrasis greitis priklauso nuo atminties pralaidumo, GPU posistemės ir konkretaus modelio, o ne vien nuo atminties kiekio.
Ar mano duomenys lieka privatūs, kai modelis veikia vietoje?
Taip, ta prasme, kad jūsų užklausos lieka jūsų kompiuteryje, o ne siunčiamos debesijos paslaugos teikėjui. Ollama pagal numatytuosius nustatymus susiejama su jūsų nešiojamuoju ir niekur kitur užklausų nesiunčia, nebent sąmoningai sukonfigūruojate prieigą prie debesijos.
Išbandykite šiandien, o tada rinkitės užtikrintai
Jau turite 16 GB nešiojamąjį? Įsidiekite Ollama dar šiandien ir paleiskite vieną mažą modelį prieš išleisdami bent centą kažkam naujam. Perkate kompiuterį būtent tam? Tegul aukščiau esantis kontrolinis sąrašas ir penki ką tik aptarti atnaujinti nešiojamieji būna pirmasis jūsų palyginimo taškas, o ne rinkodarinė specifikacijų lentelė.
Kiekvienas refurbed nešiojamasis prieš patenkant į prekybą yra patikrinamas ir įvertinamas, todėl perkate būtent tą RAM ir tą konfigūraciją, kuri nurodyta. Kitame šios serijos gide parodysime, kaip prie ką tik išbandyto modelio prijungti pirmąją programą.


Pirmą kartą užsisakykite mūsų naujienlaiškį ir sutaupykite 15 €!
Nebepraleisk nė vieno pasiūlymo.
Informaciją apie asmens duomenų naudojimą rasi mūsų Privatumo politikoje.
Atsisiųsti refurbed programėlę
Skirta iOS ir Android


Patvirtinti registraciją
Beveik baigta: jums išsiuntėme patvirtinimo laišką
- © Refurbed Marketplace GmbH
- Prieinamumas
- Taisyklės ir sąlygos
- Privatumo politika
- Leidėjo duomenys
- Teisinė informacija
- European Data Act
- Cookie Policy